Seedance 2.5: 30 secondi in una sola generazione
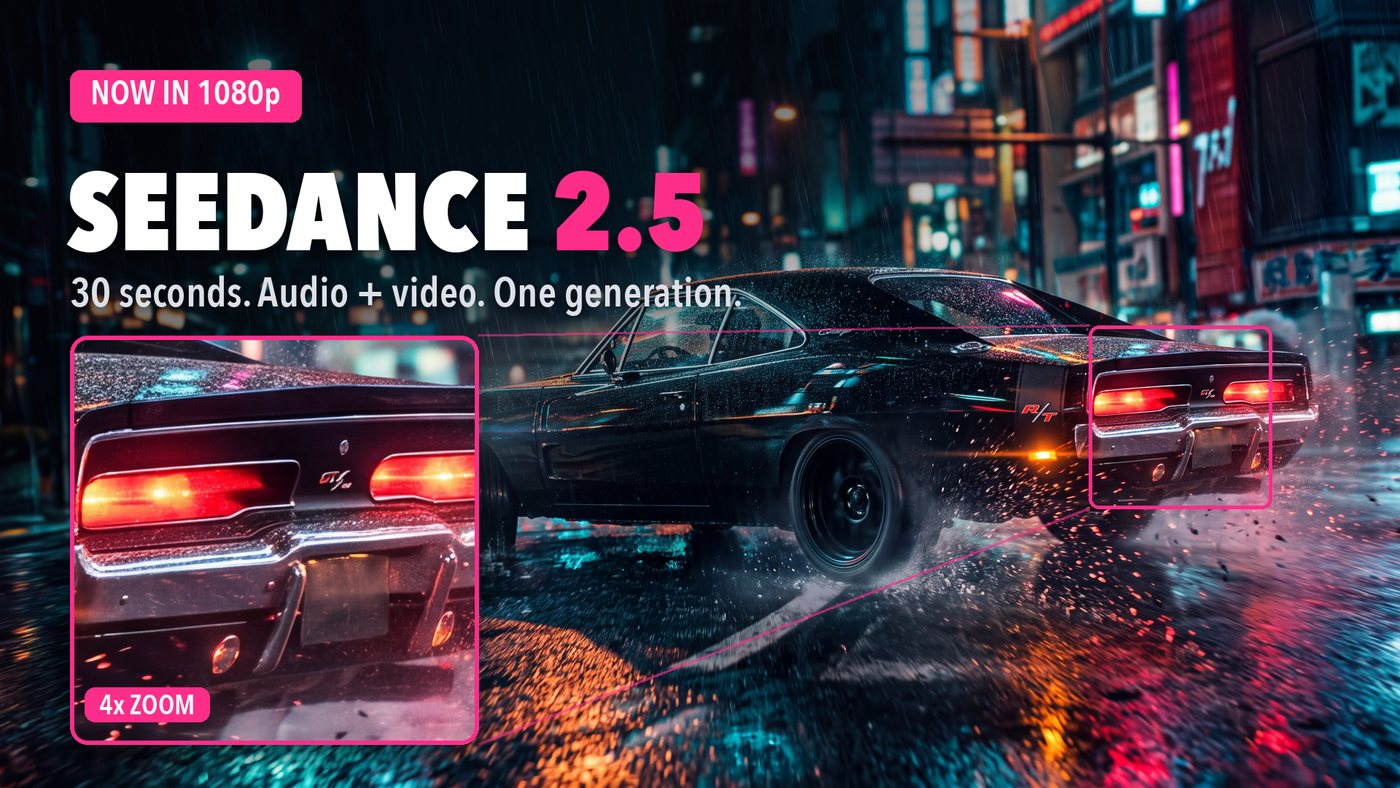
Il nuovo modello audio-video di ByteDance, ora su Covely. Immagine e suono vengono generati insieme in un solo passaggio, il movimento è più fluido e più coerente, e una singola generazione arriva adesso a 30 secondi pieni.
Seedance 2.5
→ 30 secondi in una sola ripresa
Una generazione, fino a 30 secondi, e puoi estenderla due volte quando la storia ha bisogno di più spazio. Scene intere invece di clip da cucire insieme.
→ E ora anche in 1080p
I trenta secondi completi vengono renderizzati in 1080p, quindi quello che esce dalla generazione è quello che pubblichi.
→ Audio e video, generati insieme
È un modello audio-video congiunto: il suono esce dalla stessa generazione dell'immagine, invece di essere aggiunto sopra dopo.
→ Legge il tuo riferimento, non solo il movimento
Dagli in pasto un video di riferimento e ne coglie l'inquadratura e il linguaggio cinematografico, non solo il movimento. In più l'output in green screen e il controllo vero sui movimenti di macchina per il lavoro di produzione.